


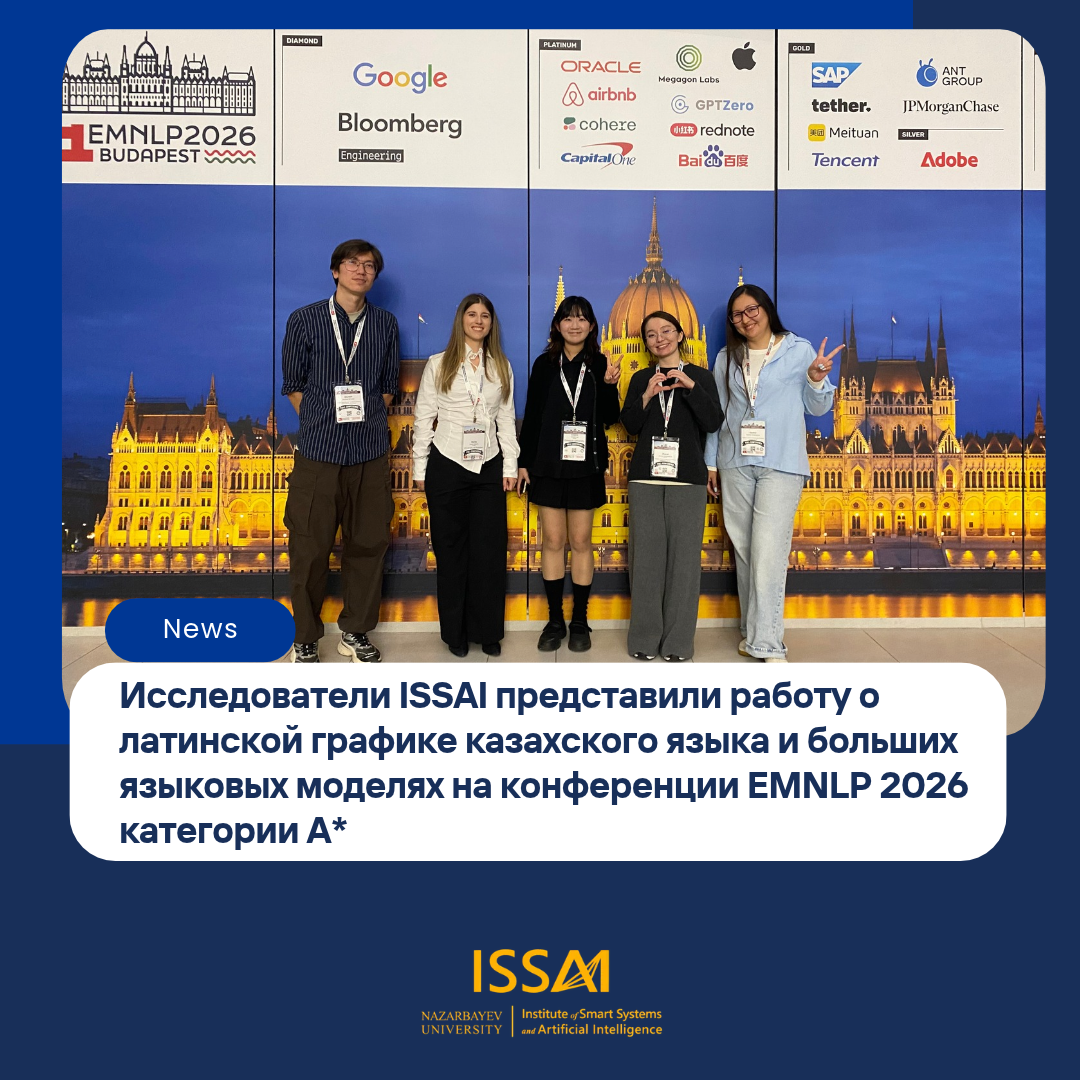
27 октября 2026 года исследователи Института умных систем и искусственного интеллекта (ISSAI) Назарбаев Университета Акылбек Максутов и доктор Жанат Макатаева представили результаты своего исследования на международной конференции по эмпирическим методам обработки естественного языка EMNLP 2026, которая проходила с 24 по 29 октября в Будапеште, Венгрия.
Научная работа под названием «Пересекают ли большие языковые модели границы алфавитов? Сравнительная оценка больших языковых моделей на основе четырех предлагаемых вариантов латинской графики казахского языка» была подготовлена в соавторстве с Галаммадином Аскаром, Арайлым Мухаметкали, Нурали Медеу и профессором Хусейном Атаканом Варолом, директором-основателем ISSAI и деканом Школы вычислительной техники и искусственного интеллекта (SCAI) Назарбаев Университета.
Исследование посвящено оценке того, насколько эффективно большие языковые модели (LLM) обрабатывают казахский язык, написанный латиницей. Эта тема приобретает особую актуальность в контексте обсуждения перехода казахского языка с кириллицы на латиницу в Казахстане.
Исследователи оценили 13 языковых моделей на трех тестовых наборах — KazMMLU, KazCulture и GSM8k-Kazakh, адаптированных к четырем предлагаемым вариантам латинской графики казахского языка. Сравнивая результаты моделей при использовании разных систем письма, авторы изучили, как различия в графике влияют на точность и надежность AI-систем, работающих с казахским языком.
Результаты показали, что при обработке казахского текста латиницей вместо кириллицы средняя точность моделей снижается на 16,8 процентного пункта. Исследование также выявило, что одними лишь различиями в токенизации нельзя полностью объяснить этот разрыв в результатах. Методы, основанные на изменении промптов, обеспечили лишь ограниченное улучшение, тогда как дообучение с использованием LoRA позволило повысить точность на величину до 20 процентных пунктов у достаточно крупных моделей, способных к логическому рассуждению.
Полученные результаты подчеркивают важность обеспечения надежного понимания казахского языка языковыми моделями независимо от используемой системы письма. По мнению авторов, для повышения качества моделей необходимо включать данные на казахском языке в латинской графике в процесс предварительного обучения или масштабного дополнительного обучения. Полагаться исключительно на корректировку промптов недостаточно.
Исследование выполнено в рамках проекта Казахского национального университета имени аль-Фараби (КазНУ) «Создание большой языковой модели (LLM) для поддержки внедрения казахского языка и развития технологического прогресса» (регистрационный номер программы — BR24993001).
Проводя исследования в области технологий казахского языка и многоязычного искусственного интеллекта, ISSAI вносит вклад в разработку AI-систем, которые в большей степени учитывают языковые потребности Казахстана. Представление этой работы на EMNLP 2026 позволило поделиться результатами исследований по обработке казахского языка с международным научным сообществом в области обработки естественного языка и внести вклад в создание более инклюзивных AI-систем с расширенными языковыми возможностями.