


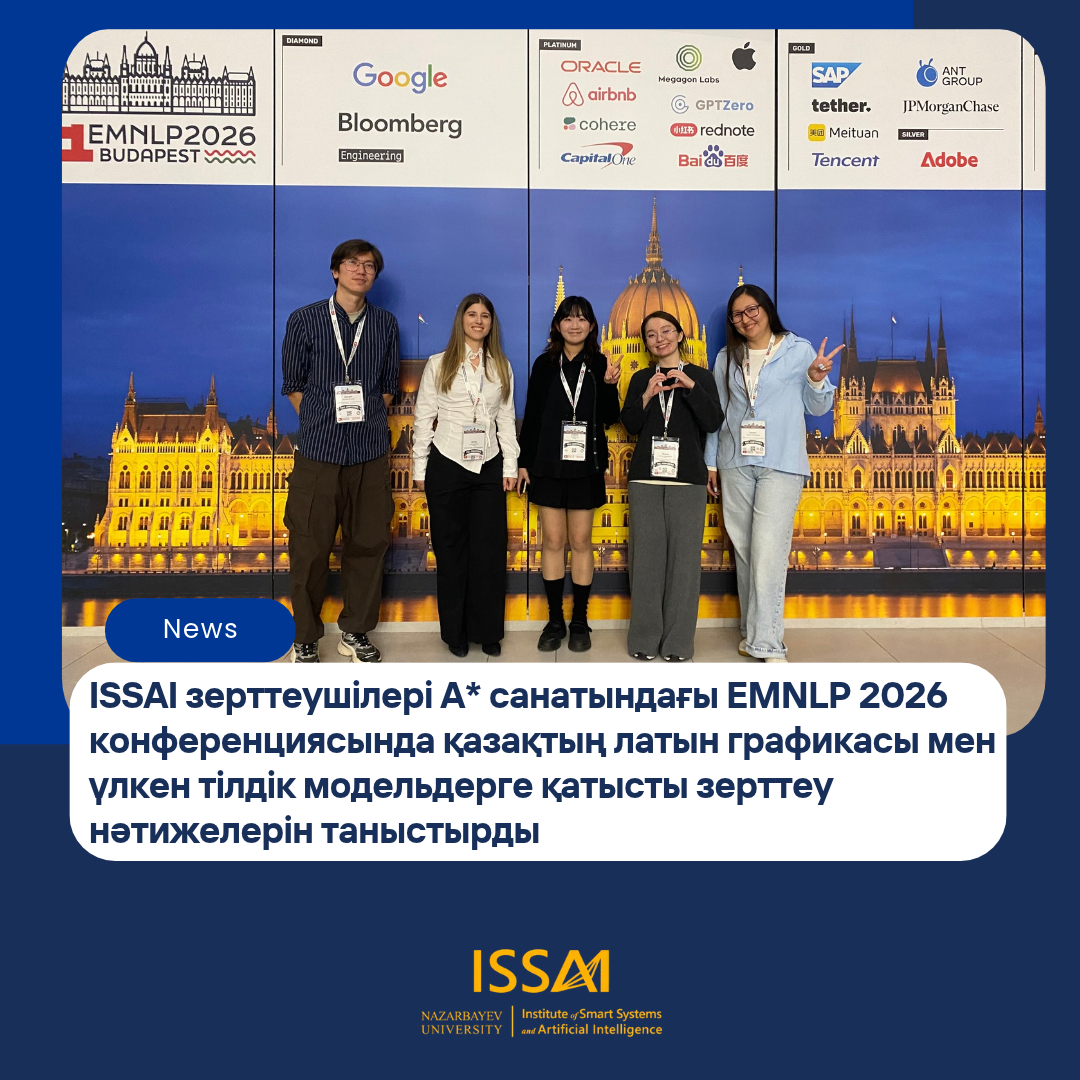
2026 жылғы 27 қазанда Назарбаев Университетінің Ақылды жүйелер және жасанды интеллект институтының (ISSAI) зерттеушілері Ақылбек Максутов пен доктор Жанат Макатаева 24–29 қазан аралығында Венгрияның Будапешт қаласында өткен табиғи тілді өңдеудің эмпирикалық әдістеріне арналған EMNLP 2026 халықаралық конференциясында өз зерттеулерін таныстырды.
Зерттеу жұмысы «Үлкен тілдік модельдер әртүрлі әліпбилерді меңгере ала ма? Қазақ тілінің латын графикасына көшудің төрт ұсынылған нұсқасы негізінде үлкен тілдік модельдерді салыстырмалы бағалау» деп аталады. Оның авторлары — Ғаламмадин Асқар, Арайлым Мұхаммедқали, Нұрали Медеу және Назарбаев Университетінің ISSAI институтының негізін қалаушы директоры әрі Есептеу техникасы және жасанды интеллект мектебінің (SCAI) деканы, профессор Хусейн Атакан Варол.
Зерттеу үлкен тілдік модельдердің (LLM) латын графикасымен жазылған қазақ тілін қаншалықты тиімді өңдей алатынын қарастырады. Бұл тақырып Қазақстанда қазақ тілін кирилл әліпбиінен латын графикасына көшіру мәселесі талқыланып жатқан кезеңде ерекше өзекті.
Зерттеушілер қазақ тілінің латын графикасына негізделген төрт ұсынылған нұсқасына бейімделген үш бағалау жиынтығы — KazMMLU, KazCulture және GSM8k-Kazakh — бойынша 13 тілдік модельді сынақтан өткізді. Әртүрлі жазу жүйелеріндегі модельдердің нәтижелерін салыстыру арқылы зерттеу графикалық айырмашылықтардың қазақ тілінде жұмыс істейтін AI жүйелерінің дәлдігі мен сенімділігіне қалай әсер ететінін анықтауға бағытталды.
Нәтижелер модельдер қазақ тілін кирилл графикасының орнына латын графикасымен өңдегенде, орташа дәлдік көрсеткіші 16,8 пайыздық тармаққа төмендейтінін көрсетті. Сонымен қатар бұл айырмашылықты тек токенизациядағы ерекшеліктермен түсіндіру мүмкін емес екені анықталды. Промпттарды өзгертуге негізделген әдістер шектеулі жақсару бергенімен, LoRA әдісімен қосымша оқыту жеткілікті көлемдегі әрі логикалық пайымдауға қабілетті модельдердің нәтижесін 20 пайыздық тармаққа дейін жақсартуға мүмкіндік берді.
Зерттеу нәтижелері тілдік модельдердің қазақ тілін әртүрлі жазу жүйелерінде сенімді түсінуін қамтамасыз етудің маңызын көрсетеді. Авторлардың пікірінше, модельдердің тиімділігін арттыру үшін қазақ тілінің латын графикасындағы деректерін бастапқы оқыту кезеңіне немесе ауқымды қосымша оқыту үдерісіне енгізу қажет. Тек промпттарды өзгертуге негізделген тәсілдерге сүйену жеткіліксіз.
Зерттеу әл-Фараби атындағы Қазақ ұлттық университетінің (ҚазҰУ) «Қазақ тілін қолданысқа енгізуді қолдау және технологиялық прогресті дамытуға арналған үлкен тілдік модельді (LLM) жасау» жобасы аясында жүргізілді. Бағдарламаның тіркеу нөмірі (IRN): BR24993001.
Қазақ тіліне арналған технологиялар мен көптілді жасанды интеллект бағытындағы зерттеулері арқылы ISSAI Қазақстанның тілдік қажеттіліктерін ескеретін AI жүйелерін дамытуға үлес қосып келеді. EMNLP 2026 конференциясында бұл зерттеуді таныстыру қазақ тілін өңдеу саласындағы ғылыми нәтижелерді халықаралық табиғи тілді өңдеу қауымдастығына ұсынуға және инклюзивті, тілдік мүмкіндіктері кең жасанды интеллект жүйелерін дамытуға үлес қосуға мүмкіндік берді.